Duplex Sequencing 원리: PCR 오류와 실제 저빈도 DNA 변이를 구별하는 방법
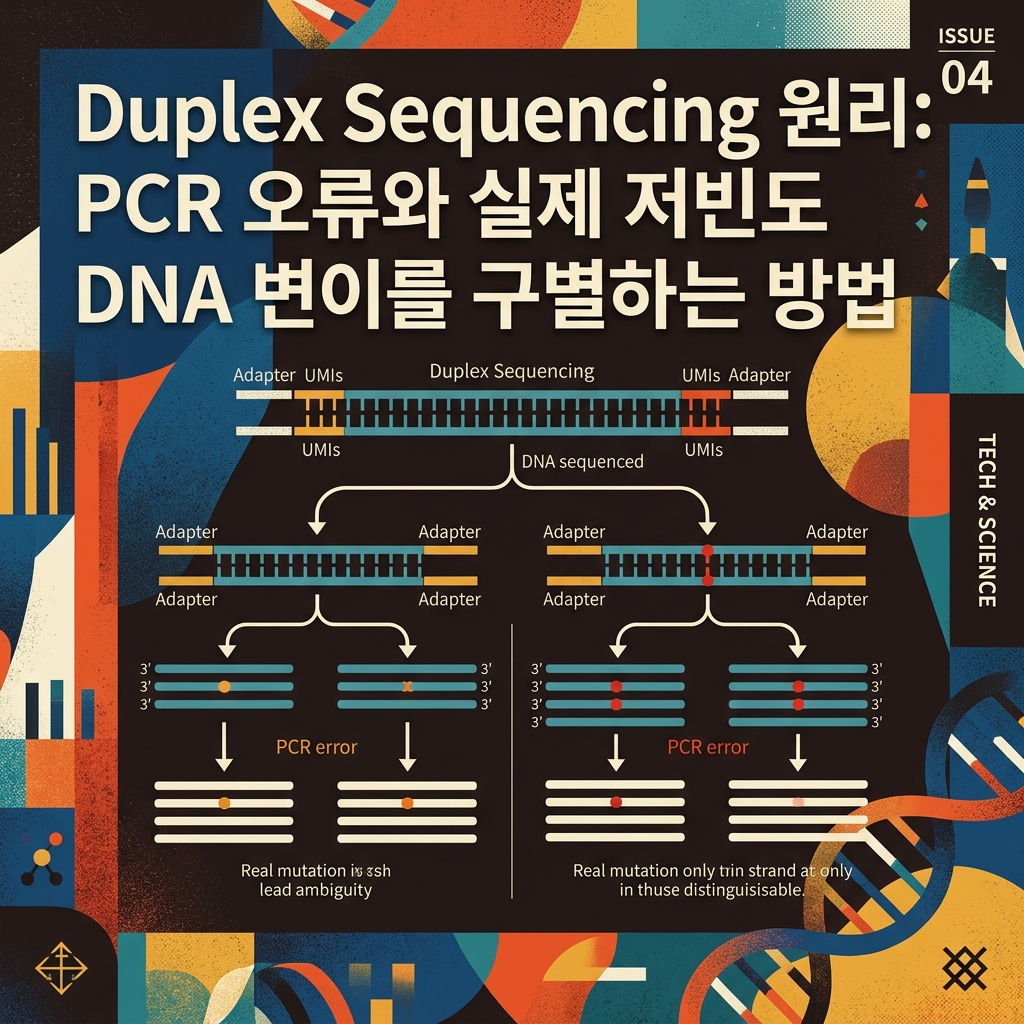
차세대염기서열분석(NGS)에서 낮은 빈도의 변이가 검출되더라도 실제 DNA에 존재하던 변이라고 단정할 수는 없습니다. Duplex Sequencing은 원본 DNA의 양쪽 가닥을 독립적으로 분석한 뒤 결과를 대조해, 증폭 및 시퀀싱 과정에서 발생한 오류를 줄이는 기술입니다.
1. NGS에서 0.1% 변이가 검출되면 실제 변이일까?
암 유전자 분석에서는 정상 DNA가 대부분을 차지하고 변이 DNA는 극히 적은 비율로 존재할 수 있습니다.
예를 들어 특정 유전자 위치에서 10,000개의 sequencing read를 확보했고, 이 가운데 10개에서 정상 서열과 다른 염기가 검출됐다고 가정해 보겠습니다.
단순히 read 수로 계산하면 변이 비율은 0.1%입니다.
하지만 이 결과만으로 원본 DNA에 실제 변이가 존재했다고 판단하기는 어렵습니다.
DNA polymerase가 잘못된 염기를 삽입했을 수 있고, sequencing 과정에서 잘못된 염기 판독이 발생했을 수도 있기 때문입니다.
특히 PCR 초기에 발생한 오류는 후속 증폭 과정에서 여러 read로 복제됩니다. 이 경우 서로 같은 변이를 가진 read가 여러 개 관찰되더라도 하나의 초기 오류에서 유래했을 가능성이 있습니다.
Duplex Sequencing은 이러한 문제를 해결하기 위해 원본 이중가닥 DNA의 두 가닥이 동일한 변이 정보를 가지고 있는지 확인합니다.
Sequencing Depth만 늘리면 해결되지 않는 이유
같은 원본 DNA에서 유래한 PCR 복제물을 수천 번 읽는다고 해서 원본 DNA 분자 수가 늘어나는 것은 아닙니다.
특히 PCR 초기에 잘못된 염기가 삽입되면 해당 오류를 가진 복제물도 반복적으로 읽힐 수 있습니다.
따라서 저빈도 변이 분석에서는 전체 read 수보다 서로 독립적인 원본 DNA 분자를 얼마나 정확하게 분석했는가가 중요합니다.
2. Duplex Sequencing은 DNA 양쪽 가닥을 어떻게 구별할까?
Duplex Sequencing의 핵심은 원본 이중가닥 DNA를 구성하는 두 가닥의 정보를 독립적으로 추적하는 것입니다.
일반적인 NGS에서는 DNA를 절편화하고 adapter를 연결한 뒤 PCR로 증폭합니다.
하지만 PCR 이후 생성된 read만으로는 어떤 read가 동일한 원본 DNA에서 유래했는지 구별하기 어려울 수 있습니다.
Duplex Sequencing에서는 원본 DNA에 고유한 식별 정보를 가진 adapter를 연결합니다.
이 adapter에는 원본 DNA 분자를 식별하고 상보적인 두 가닥의 관계를 추적할 수 있는 barcode 구조가 포함됩니다.
이후 PCR과 sequencing을 수행하면 같은 원본 가닥에서 유래한 read를 하나의 family로 묶을 수 있습니다.
대표적인 분석 과정은 다음과 같습니다.
Original Double-Stranded DNA
→ Duplex Barcode Adapter Ligation
→ PCR Amplification
→ NGS Sequencing
→ Read Family Grouping
→ Single-Strand Consensus Sequence
→ Duplex Consensus Sequence
이 과정에서 가장 중요한 단계는 단순한 barcode 부착이 아니라, 원본 DNA의 두 가닥을 서로 대응시킬 수 있도록 정보를 보존하는 것입니다.
3. Single-Strand Consensus와 Duplex Consensus의 차이
Duplex Sequencing에서는 일반적으로 두 단계의 consensus 분석을 수행합니다.
Single-Strand Consensus Sequence(SSCS)
먼저 동일한 원본 DNA 가닥에서 유래한 sequencing read를 모읍니다.
예를 들어 한 원본 가닥에서 유래한 read가 10개 있다고 가정하겠습니다.
이 가운데 9개는 특정 위치를 A로 판독하고 1개만 G로 판독했다면, 단독으로 발생한 G 신호는 sequencing error일 가능성이 있습니다.
여러 read의 정보를 종합해 해당 원본 가닥의 consensus sequence를 생성합니다.
이것이 SSCS입니다.
SSCS는 후속 sequencing 과정에서 개별 read에 발생한 오류를 줄이는 데 유용합니다.
하지만 SSCS에도 중요한 한계가 있습니다.
원본 DNA 한 가닥에 이미 존재하던 손상이나 초기 증폭 과정에서 발생한 오류는 SSCS에 남을 수 있습니다.
Duplex Consensus Sequence(DCS)
DCS는 원본 이중가닥 DNA의 서로 상보적인 두 가닥에서 생성한 SSCS를 비교합니다.
실제 이중가닥 DNA에 고정된 염기 치환이 존재한다면, 두 가닥은 서로 상보적인 변이 정보를 가져야 합니다.
반면 한 가닥에만 존재하는 손상이나 오류는 다른 가닥에서 일치하는 정보를 얻지 못할 수 있습니다.
따라서 DCS에서는 두 가닥의 정보가 일치하는 위치를 중심으로 신뢰도 높은 consensus를 구성합니다.
이것이 Duplex Sequencing의 오류 억제 원리입니다.
4. 실제 변이와 DNA 손상은 어떻게 구별할까?
Duplex Sequencing을 이해하려면 DNA mutation과 DNA damage를 구분해야 합니다.
DNA mutation은 유전정보의 염기서열이 변화한 상태를 의미합니다.
반면 DNA damage는 염기의 화학적 구조가 변형된 상태일 수 있습니다.
예를 들어 cytosine이 탈아미노화되면 uracil로 전환될 수 있습니다.
이러한 손상이 DNA 한 가닥에만 존재하면 polymerase가 해당 위치를 복제하는 과정에서 잘못된 염기를 삽입할 수 있습니다.
그 결과 sequencing에서는 실제 원본 이중가닥 DNA에 고정되지 않았던 변이가 관찰될 수 있습니다.
Duplex Sequencing은 원본 DNA의 두 가닥을 비교해 이러한 단일가닥 유래 오류를 구별하는 데 도움을 줍니다.
| 분석 상황 | 한쪽 가닥 | 상보 가닥 | 해석 |
|---|---|---|---|
| 실제 고정된 염기 치환 | 변이 정보 존재 | 상보적인 변이 정보 존재 | 실제 변이의 근거 강화 |
| 단일가닥 DNA 손상 | 비정상 염기 신호 | 정상 정보 유지 | 손상 유래 오류 가능성 |
| 개별 sequencing error | 일부 read에서만 발생 | 일치하지 않음 | Consensus에서 제거 가능 |
| 초기 PCR 오류 | 한 가닥의 일부 복제물에 발생 | 일반적으로 일치하지 않음 | Duplex 비교로 억제 가능 |
다만 두 가닥에 동일한 위치의 오류가 발생하거나 DNA library preparation 과정에서 특정 오류가 양쪽 가닥에 고정된다면 DCS만으로 완전히 제거하기 어려울 수 있습니다.
따라서 Duplex Sequencing을 오류가 전혀 발생하지 않는 기술로 이해해서는 안 됩니다.
5. 원천 연구에서는 얼마나 낮은 오류율을 보고했을까?
Duplex Sequencing은 2012년 Schmitt와 연구진이 *Proceedings of the National Academy of Sciences(PNAS)*에 발표한 연구에서 소개됐습니다.
연구진은 원본 이중가닥 DNA의 두 가닥을 독립적으로 추적하고 비교하면 일반적인 sequencing error를 크게 줄일 수 있다는 점을 제시했습니다.
해당 연구에서는 이론적인 background error rate가 10억 개의 염기당 인공적인 변이 1개 미만 수준까지 낮아질 수 있다고 설명했습니다.
이 수치는 Duplex Sequencing의 원리를 이해하는 데 중요하지만, 모든 실제 검체에서 10억 분의 1 수준의 변이를 검출할 수 있다는 의미는 아닙니다.
실제 검출한계는 확보한 원본 DNA 분자 수와 양쪽 가닥의 회수율, library preparation 과정에서 발생하는 오류 등에 영향을 받습니다.
2014년 Kennedy와 연구진이 Nature Protocols에 발표한 분석법에서는 1,000만 개 이상의 정상 염기 가운데 존재하는 단일 변이를 검출할 수 있는 수준의 분석 능력을 기술했습니다.
또한 해당 프로토콜은 Duplex Sequencing이 이중가닥 DNA 시료에 적용될 수 있지만, 당시 구현에서는 비교적 제한된 유전체 영역의 분석에 적합하다고 설명했습니다.
여기서 구분해야 할 것은 다음 두 가지입니다.
- Background Error Rate: 기술적으로 발생하는 잘못된 변이 신호의 빈도
- Practical Detection Limit: 실제 검체와 분석 조건에서 신뢰성 있게 검출할 수 있는 변이 수준
이론적인 오류율이 낮아도 원본 DNA가 충분하지 않으면 극소수의 변이를 검출할 수 없습니다.
6. 원본 DNA가 부족하면 어떤 문제가 발생할까?
Duplex Sequencing에서 가장 중요한 제한 요소 가운데 하나는 원본 DNA 분자의 수입니다.
예를 들어 특정 유전자 위치를 포함하는 독립적인 이중가닥 DNA 분자 1,000개를 분석했다고 가정하겠습니다.
이 가운데 변이 DNA가 1개 존재한다면 원본 분자 기준 변이 비율은 0.1%입니다.
하지만 변이 비율이 0.01%라면 평균적으로 10,000개의 원본 DNA 분자 가운데 1개에 해당합니다.
따라서 실제로 분석한 원본 분자가 1,000개뿐이라면 해당 변이를 포함하는 DNA를 확보하지 못할 가능성이 큽니다.
단순한 확률 모델에서 변이 비율을 (f), 독립적으로 분석한 원본 분자 수를 (N)이라고 하면 변이 분자가 하나도 포함되지 않을 확률은 다음과 같습니다.
[
P(0)=(1-f)^N
]
예를 들어 변이 비율이 0.01%이고 독립적인 원본 DNA 분자 10,000개를 분석한다면, 변이 분자를 하나도 관찰하지 못할 확률은 약 36.8%입니다.
이는 단순한 이항분포 기반 예시이며, 실제 검출 확률에는 DNA recovery와 assay efficiency 등이 추가로 영향을 줍니다.
이 계산에서 얻을 수 있는 중요한 결론은 오류율이 낮은 기술을 사용하더라도 충분한 원본 분자가 없으면 저빈도 변이를 안정적으로 검출할 수 없다는 점입니다.
Read Depth와 Molecular Depth는 다르다
NGS 결과에서 read depth가 100,000이라고 해도 독립적인 원본 DNA 분자가 100,000개였다는 의미는 아닙니다.
하나의 원본 DNA에서 PCR로 생성된 여러 복제물이 포함될 수 있기 때문입니다.
Duplex Sequencing에서는 원본 이중가닥 DNA의 두 가닥에서 consensus를 확보한 분자 수가 중요합니다.
따라서 분석 결과를 해석할 때는 전체 read depth뿐 아니라 duplex consensus를 구성한 독립적인 분자 수를 확인해야 합니다.
7. Duplex Sequencing에서 검출 성능이 떨어지는 원인
Duplex Sequencing은 높은 정확도를 제공할 수 있지만 모든 원본 DNA 분자가 최종 분석에 사용되는 것은 아닙니다.
특히 다음 세 가지 문제가 중요합니다.
첫째, 한쪽 DNA 가닥의 손실
Duplex Consensus를 생성하려면 원본 DNA의 두 가닥에서 각각 충분한 sequencing 정보를 확보해야 합니다.
하지만 library preparation이나 PCR 과정에서 한쪽 가닥이 손실될 수 있습니다.
이 경우 다른 가닥의 read가 충분하더라도 완전한 DCS를 구성하지 못할 수 있습니다.
따라서 Duplex Sequencing에서는 단순한 sequencing read 수뿐 아니라 양쪽 가닥을 모두 회수하는 효율이 중요합니다.
둘째, DNA 절편화와 말단 복구 과정의 오류
DNA를 절편화하거나 adapter를 연결하기 위해 말단을 처리하는 과정에서 DNA 손상이나 잘못된 염기 삽입이 발생할 수 있습니다.
특히 DNA end repair 과정에서 발생한 일부 오류는 원본 DNA의 변이처럼 해석될 가능성이 있습니다.
따라서 library preparation 조건과 DNA fragment의 품질을 관리해야 합니다.
셋째, Barcode와 Read Family 분석 오류
Duplex Sequencing은 barcode를 이용해 read가 유래한 원본 DNA 분자를 추적합니다.
하지만 barcode collision이나 sequencing error가 barcode 자체에 발생하면 read family를 잘못 분류할 가능성이 있습니다.
또한 family size가 지나치게 작으면 안정적인 SSCS를 생성하기 어려울 수 있습니다.
반대로 특정 분자에서 유래한 read만 과도하게 많으면 전체 sequencing resource가 비효율적으로 사용될 수 있습니다.
따라서 barcode design과 consensus calling threshold를 함께 최적화해야 합니다.
8. 일반 UMI Sequencing과 Duplex Sequencing 중 무엇을 선택할까?
Unique Molecular Identifier(UMI)는 원본 DNA 분자에 고유한 식별자를 부여해 PCR duplicate를 구별하는 데 사용됩니다.
UMI 기반 sequencing은 일반 NGS보다 오류를 줄이는 데 도움이 될 수 있습니다.
하지만 단일가닥 consensus만 사용하는 방식에서는 원본 DNA 한 가닥에 이미 존재하던 손상이나 오류를 완전히 구별하기 어려울 수 있습니다.
Duplex Sequencing은 이러한 문제를 해결하기 위해 두 가닥의 정보를 대조합니다.
| 판단 기준 | 일반 UMI 기반 Consensus Sequencing | Duplex Sequencing |
|---|---|---|
| 원본 분자 구별 | 가능 | 가능 |
| PCR duplicate 구분 | 가능 | 가능 |
| 단일가닥 consensus | 가능 | 가능 |
| 원본 DNA 양쪽 가닥 비교 | 설계에 따라 제한적 | 핵심 원리 |
| 단일가닥 손상 유래 오류 억제 | 제한적일 수 있음 | 상대적으로 유리 |
| 분석 데이터 요구량 | 상대적으로 적을 수 있음 | 양쪽 가닥 확보가 필요 |
Duplex Sequencing은 매우 낮은 빈도의 변이를 신뢰성 있게 분석하려는 연구에서 유리할 수 있습니다.
반면 일반적인 변이 분석이나 충분히 높은 VAF의 변이를 검출하는 상황에서는 Duplex Sequencing의 추가적인 library preparation과 sequencing 비용이 반드시 필요한 것은 아닙니다.
따라서 분석 목적과 요구되는 오류율을 기준으로 기술을 선택해야 합니다.
9. 암 액체생검에서 Duplex Sequencing을 사용할 때 고려할 점
혈액 기반 액체생검에서는 circulating tumor DNA(ctDNA)를 분석할 수 있습니다.
하지만 혈액 속 cell-free DNA(cfDNA)의 대부분은 종양이 아닌 정상 조직에서 유래할 수 있습니다.
따라서 ctDNA의 비율이 낮으면 일반적인 NGS에서 변이 신호와 기술적 오류를 구별하기 어려울 수 있습니다.
Duplex Sequencing은 이러한 상황에서 저빈도 변이의 신뢰도를 높이는 접근으로 활용할 수 있습니다.
다만 실제 액체생검에서는 추가적인 문제가 존재합니다.
우선 채혈과 검체 보관 과정에서 DNA 품질이 달라질 수 있습니다.
또한 cfDNA는 상대적으로 짧은 fragment로 존재하기 때문에 library preparation에서 원본 DNA 손실을 최소화하는 것이 중요합니다.
혈액세포 유래 clonal hematopoiesis 변이가 ctDNA 분석에 영향을 줄 가능성도 고려해야 합니다.
이러한 변이는 실제 DNA에 존재하는 생물학적 변이이므로 Duplex Sequencing으로 오류를 제거하더라도 자동으로 종양 유래 변이와 구분되는 것은 아닙니다.
따라서 정확한 염기 판독과 종양 유래 여부의 판단은 서로 다른 문제입니다.
10. Duplex Sequencing의 연구적 가치와 한계
Duplex Sequencing의 가장 큰 장점은 DNA가 원래 가지고 있는 이중가닥 구조를 오류 검증에 활용한다는 것입니다.
일반적인 sequencing에서는 하나의 DNA 가닥에서 얻은 정보를 반복적으로 읽고 consensus를 생성합니다.
Duplex Sequencing은 여기에 상보 가닥의 독립적인 정보를 추가합니다.
그 결과 단일가닥 손상과 일부 PCR·sequencing error를 구별하는 능력이 향상됩니다.
이러한 접근은 암 관련 저빈도 체세포 변이 연구와 DNA 손상 분석, 돌연변이 발생 빈도 연구 등에 활용될 수 있습니다.
하지만 실제 검출 성능은 분석 가능한 원본 DNA 분자 수에 제한됩니다.
또한 양쪽 가닥의 정보를 모두 확보해야 하므로 DNA recovery와 sequencing efficiency가 중요합니다.
따라서 Duplex Sequencing은 단순히 sequencing depth를 높이는 기술이 아닙니다.
원본 DNA의 두 가닥을 독립적으로 검증해 변이 판독의 신뢰도를 높이는 오류 억제 기술입니다.
연구자가 저빈도 변이를 분석할 때는 다음 질문을 먼저 검토해야 합니다.
- 실제로 분석한 독립적인 원본 DNA 분자는 몇 개인가?
- 양쪽 DNA 가닥에서 충분한 consensus 정보를 확보했는가?
- DNA 손상이나 library preparation에서 발생한 오류를 어떻게 관리했는가?
- 검출된 변이가 기술적 오류가 아닌 실제 생물학적 변이라는 근거가 충분한가?
- 검출된 변이가 특정 질환과 관련 있다는 임상적 근거가 있는가?
이 질문에 답할 수 있어야 낮은 변이 비율을 신뢰성 있게 해석할 수 있습니다.
참고문헌
1. Schmitt MW, Kennedy SR, Salk JJ, et al. (2012).
Detection of ultra-rare mutations by next-generation sequencing.
Proceedings of the National Academy of Sciences, 109(36), 14508–14513.
Duplex Sequencing의 기본 원리를 제시한 원천 연구입니다. 원본 이중가닥 DNA의 양쪽 가닥을 독립적으로 분석해 PCR·sequencing error를 줄이는 접근을 설명합니다.
2. Kennedy SR, Schmitt MW, Fox EJ, et al. (2014).
Detecting ultralow-frequency mutations by Duplex Sequencing.
Nature Protocols, 9, 2586–2606.
Duplex Sequencing의 adapter 구성과 library preparation, consensus sequence 분석 방법을 설명한 실험 프로토콜입니다.
3. Detection of Low-Frequency Mutations and Identification of Heat-Induced Artifactual Mutations Using Duplex Sequencing (2019).
PubMed: PMID 30625989
일반 NGS와 단일가닥 consensus, duplex consensus의 저빈도 변이 검출 결과를 비교하고, 열에 의해 발생하는 인공적인 변이 신호를 분석한 연구입니다.
※ 본 글은 공개된 학술논문의 원리와 연구 결과를 바탕으로 작성한 교육용 콘텐츠입니다. Duplex Sequencing의 분석적 정확도가 모든 검체에서 동일한 검출한계나 임상 진단 성능을 보장하는 것은 아닙니다.


댓글 0
첫 댓글을 남겨보세요.