BDA 유전자 변이 검출 원리: 정상 DNA 증폭을 억제하는 Blocker의 역할
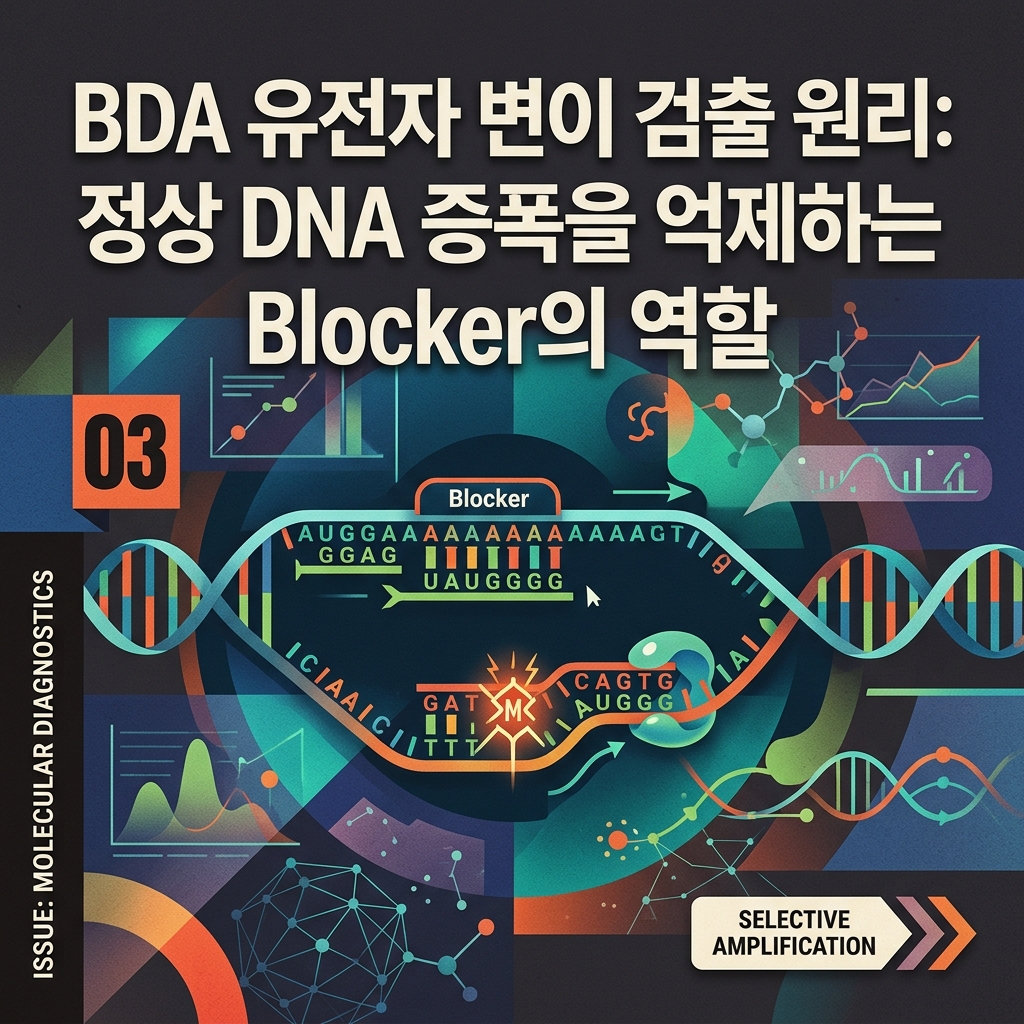
혈액이나 종양 조직에서 변이 DNA가 전체의 0.1%에 불과하다면 일반 PCR로는 정상 DNA와 변이 DNA를 구별하기 어려울 수 있습니다. Blocker Displacement Amplification(BDA)은 정상 DNA에 결합하는 차단 탐침을 이용해 변이 서열을 선택적으로 농축하는 기술입니다.
1. 변이 DNA가 0.1%인데 PCR로 증폭하면 왜 찾기 어려울까?
암 관련 유전자 변이를 분석할 때 가장 큰 어려움 가운데 하나는 정상 DNA가 변이 DNA보다 훨씬 많이 존재한다는 점입니다.
예를 들어 검체에 특정 유전자 영역을 포함하는 DNA 분자가 10,000개 있다고 가정해 보겠습니다.
이 가운데 9,990개는 정상 서열이고 나머지 10개만 변이 서열이라면 변이 대립유전자 비율(Variant Allele Frequency, VAF)은 0.1%입니다.
일반적인 PCR에서는 정상 DNA와 변이 DNA가 모두 증폭될 수 있습니다. 두 서열의 증폭 효율이 비슷하다면 PCR 이후에도 변이 비율은 크게 달라지지 않습니다.
따라서 PCR 산물이 충분히 생성되더라도 Sanger sequencing에서는 소수의 변이 신호가 정상 서열에 가려질 수 있습니다.
이 문제를 해결하는 방법 가운데 하나는 정상 DNA와 변이 DNA를 동일하게 증폭하지 않는 것입니다.
BDA는 정상 DNA의 증폭을 상대적으로 억제하고 변이 DNA가 우선적으로 증폭되도록 설계한 PCR 기반 농축 기술입니다.
2017년 Wu와 연구진은 Nature Biomedical Engineering에 발표한 연구에서 이러한 접근을 Blocker Displacement Amplification이라고 명명했습니다.
연구진은 약 20개 염기 길이의 분석 영역에 존재하는 다양한 변이를 농축할 수 있는 방법을 제시했습니다.
이 기술의 특징은 특정 변이 하나에만 맞춘 primer를 사용하는 대신, 정상 서열에 결합하는 blocker를 이용한다는 점입니다.
2. BDA에서 Blocker는 정확히 무엇을 차단할까?
BDA의 기본 구성에는 일반적인 PCR primer와 별도의 blocker oligonucleotide가 포함됩니다.
Blocker는 정상 DNA(Wild-Type DNA)에 상보적으로 결합하도록 설계한 짧은 핵산입니다.
일반적인 PCR primer는 DNA에 결합한 뒤 polymerase에 의해 연장됩니다.
반면 BDA의 blocker는 정상 DNA에 결합해 PCR primer의 접근을 방해하는 역할을 합니다.
이를 위해 blocker와 forward primer의 결합 영역이 일부 겹치도록 설계합니다.
2017년 원천 연구에서는 두 oligonucleotide의 결합 영역이 약 6~14개 염기만큼 겹치는 구조를 사용했습니다.
이 겹치는 영역에서는 primer와 blocker가 동일한 DNA 분자에 동시에 안정적으로 결합하기 어렵습니다.
따라서 두 분자는 표적 DNA에 결합하기 위해 경쟁합니다.
이 경쟁이 BDA의 선택적 증폭을 결정합니다.
정상 DNA가 존재할 때
정상 DNA에는 blocker와 정확하게 상보적인 서열이 존재합니다.
Blocker는 정상 DNA에 안정적으로 결합합니다.
그 결과 forward primer가 해당 영역에 결합하기 어려워지고 DNA polymerase에 의한 연장이 상대적으로 억제됩니다.
정상 DNA의 PCR 증폭 효율이 낮아지는 것입니다.
변이 DNA가 존재할 때
변이 DNA에는 정상 DNA와 다른 염기가 존재합니다.
이 차이가 blocker의 결합 영역에 포함되면 blocker와 변이 DNA 사이에 mismatch가 발생할 수 있습니다.
Mismatch는 blocker-DNA 이중가닥의 안정성을 낮출 수 있습니다.
그 결과 forward primer가 blocker를 밀어내고 표적 DNA에 결합하는 과정이 상대적으로 유리해집니다.
Primer가 결합하면 polymerase가 DNA를 연장할 수 있습니다.
따라서 변이 DNA는 정상 DNA보다 효율적으로 증폭될 수 있습니다.
여기서 중요한 점은 blocker가 변이 DNA를 직접 인식하는 것이 아니라는 사실입니다.
Blocker는 정상 DNA를 강하게 인식하도록 설계되며, 변이 DNA에서는 결합 안정성이 감소하는 차이를 이용합니다.
3. Primer와 Blocker의 경쟁은 왜 변이 농축으로 이어질까?
BDA에서는 하나의 PCR cycle에서 발생하는 작은 증폭 효율 차이가 반복적으로 누적됩니다.
예를 들어 설명을 위해 변이 DNA가 한 cycle에서 정상 DNA보다 더 효율적으로 증폭된다고 가정하겠습니다.
이 차이가 여러 PCR cycle에서 반복되면 변이 DNA의 상대적 비율이 점차 높아질 수 있습니다.
실제 BDA의 농축 효율은 단순한 고정 배율로 결정되지 않습니다.
Primer와 blocker의 결합 안정성, 반응 온도, 농도, DNA sequence 등에 영향을 받기 때문입니다.
BDA 연구에서는 이러한 반응을 이해하기 위해 thermodynamic modeling과 kinetic simulation을 활용했습니다.
핵심은 primer가 blocker를 치환하는 과정의 자유에너지 변화입니다.
정상 DNA에서는 blocker가 안정적으로 결합하므로 primer displacement가 상대적으로 불리할 수 있습니다.
반면 변이 DNA에서는 mismatch로 인해 blocker의 안정성이 감소하므로 primer displacement가 유리해질 수 있습니다.
이 차이가 PCR cycle마다 반복되면서 변이 서열이 농축됩니다.
Blocker를 많이 넣으면 항상 좋은 결과가 나올까?
그렇지 않습니다.
Blocker 농도가 지나치게 낮으면 정상 DNA의 증폭을 충분히 억제하지 못할 수 있습니다.
반대로 blocker 농도가 너무 높으면 변이 DNA에서도 primer의 결합이 방해받을 수 있습니다.
따라서 blocker와 primer의 농도 비율을 적절하게 설정해야 합니다.
또한 blocker의 길이와 GC 함량에 따라 DNA 결합 안정성이 달라지므로 단순히 농도만 조절해서는 최적 조건을 찾기 어려울 수 있습니다.
4. BDA는 특정 변이를 몰라도 사용할 수 있을까?
BDA의 중요한 특징은 blocker가 결합하는 영역 안에 여러 종류의 변이가 존재할 수 있다는 점입니다.
일반적인 allele-specific PCR에서는 특정 변이 염기를 인식하도록 primer를 설계하는 경우가 많습니다.
이 경우 분석하려는 변이를 미리 알고 있어야 합니다.
반면 BDA에서는 정상 DNA 서열을 기준으로 blocker를 설계합니다.
Blocker가 결합하는 특정 영역에 염기 치환이나 작은 삽입·결실이 발생하면 blocker의 결합 안정성이 달라질 수 있습니다.
따라서 하나의 BDA 설계로 해당 영역에 존재하는 여러 변이를 농축할 가능성이 있습니다.
2017년 원천 연구에서는 약 20개 염기 길이의 영역에서 다양한 단일염기 변이를 농축하는 접근을 제시했습니다.
실험에 사용된 blocker의 고유 결합 영역은 표적에 따라 약 12~30개 염기 범위였습니다.
다만 모든 변이가 동일한 효율로 농축되는 것은 아닙니다.
변이의 위치와 종류, 주변 sequence에 따라 blocker의 결합 안정성이 다르게 변할 수 있습니다.
따라서 특정 영역의 모든 변이를 동일한 검출한계로 분석할 수 있다고 가정해서는 안 됩니다.
5. 원천 연구에서 보고된 1,000배 농축은 무엇을 의미할까?
2017년 Wu와 연구진은 BDA를 이용해 정상 DNA에 비해 변이 DNA를 1,000배 수준으로 선택적으로 농축할 수 있음을 보고했습니다.
또한 56~64°C 범위의 annealing temperature에서도 유사한 농축 성능을 유지할 수 있는 temperature-robust 설계를 제시했습니다.
이 결과는 BDA가 매우 좁은 온도 조건에서만 작동하는 방식과 구별되는 특징을 보여줍니다.
하지만 여기서 말하는 1,000배 농축을 실제 변이 DNA 분자 수가 1,000배 증가했다는 의미로만 해석해서는 안 됩니다.
정상 DNA도 일정 부분 증폭될 수 있으며, 변이 DNA의 상대적 증폭 효율이 더 높아지는 것이 핵심입니다.
또한 농축 배수는 PCR 이전과 이후의 변이 비율, 증폭 효율 등을 고려해 평가해야 합니다.
예를 들어 원래 검체의 VAF가 0.1%였다고 해서 모든 BDA 반응에서 최종 VAF가 일정한 값으로 증가하는 것은 아닙니다.
실제 농축 정도는 변이의 종류와 위치, 반응 조건, 초기 DNA 분자 수에 따라 달라집니다.
참고 연구: Wu LR 외, Multiplexed enrichment of rare DNA variants via sequence-selective and temperature-robust amplification. Nature Biomedical Engineering, 2017.
6. BDA와 COLD-PCR은 무엇이 다를까?
BDA와 COLD-PCR은 모두 정상 DNA보다 변이 DNA를 상대적으로 많이 증폭하도록 설계한 기술입니다.
그러나 두 기술의 선택적 농축 원리는 다릅니다.
COLD-PCR은 DNA 이중가닥의 녹는 특성 차이를 이용합니다.
반면 BDA는 정상 DNA에 결합하는 blocker와 PCR primer 사이의 경쟁을 이용합니다.
| 비교 항목 | COLD-PCR | BDA |
|---|---|---|
| 핵심 원리 | DNA의 열적 안정성 차이 | Primer와 Blocker의 경쟁적 결합 |
| 선택적 증폭 조건 | 임계 변성 온도 설정 | Blocker 결합 안정성과 치환 |
| 주요 설계 요소 | Amplicon의 melting 특성 | Primer-blocker overlap과 blocker sequence |
| 변이 검출 범위 | 방식에 따라 차이 | Blocker의 분석 영역 내 다양한 변이 |
| 주요 최적화 변수 | 변성 온도와 반응 조건 | Blocker 길이·농도·결합 안정성 |
BDA의 원천 연구에서는 여러 annealing temperature에서 유사한 농축 성능을 보이는 특성을 제시했습니다.
그러나 이것이 BDA가 모든 PCR 장비와 모든 온도 조건에서 동일한 성능을 보장한다는 의미는 아닙니다.
실제 분석에서는 표적별 반응 조건 검증이 필요합니다.
7. BDA에서 위양성이 발생하는 원인
BDA는 낮은 비율의 변이 DNA를 농축할 수 있지만, 이 특성 때문에 잘못된 변이 신호도 문제가 될 수 있습니다.
특히 PCR 과정에서 발생한 오류가 blocker의 정상 서열 인식에서 벗어나면 선택적으로 농축될 가능성이 있습니다.
PCR 초기 오류의 영향
PCR 초기 단계에서 polymerase가 잘못된 염기를 삽입했다고 가정해 보겠습니다.
이 오류가 blocker의 분석 영역에 발생하면 정상 서열과 다른 DNA molecule이 만들어질 수 있습니다.
이후 해당 DNA molecule은 blocker와 mismatch를 형성할 수 있습니다.
그 결과 실제 검체에 존재하지 않았던 오류 서열이 BDA에 의해 농축될 가능성이 있습니다.
따라서 BDA 결과에서 소수의 변이가 검출됐다는 사실만으로 원래 검체에 해당 변이가 존재했다고 확정해서는 안 됩니다.
DNA 손상에 의한 오류
DNA는 검체 보관과 처리 과정에서 화학적 손상을 받을 수 있습니다.
예를 들어 cytosine deamination이나 oxidative DNA damage는 후속 증폭 과정에서 잘못된 염기 판독을 유발할 수 있습니다.
이러한 손상이 변이 서열처럼 증폭되면 BDA에서 인공적인 변이 신호가 증가할 가능성이 있습니다.
따라서 검체의 DNA 품질과 library preparation, polymerase fidelity를 함께 고려해야 합니다.
정상 DNA 증폭 억제 실패
Blocker가 정상 DNA에 충분히 안정적으로 결합하지 못하면 정상 DNA도 많이 증폭될 수 있습니다.
이 경우 변이 농축 효율이 감소합니다.
특히 blocker 결합 영역에 예상하지 못한 정상 다형성이나 다른 sequence variation이 존재하면 blocker의 결합 특성이 달라질 수 있습니다.
따라서 분석 대상 영역의 알려진 polymorphism을 사전에 검토하는 것이 중요합니다.
8. BDA 결과를 Sanger Sequencing으로 확인하는 이유
일반적인 Sanger sequencing에서는 소수의 변이 신호가 정상 DNA 신호에 가려질 수 있습니다.
BDA는 변이 DNA의 상대적 비율을 높이므로 이후 Sanger sequencing에서 변이 peak를 확인하기 쉬워질 수 있습니다.
2021년 Scientific Reports에 발표된 연구에서는 BDA와 Sanger sequencing을 결합해 낮은 allele frequency의 변이를 확인하는 접근을 평가했습니다.
연구진은 Whole-Exome Sequencing(WES)에서 확인된 낮은 빈도의 후보 변이를 BDA로 농축한 뒤 Sanger sequencing으로 분석했습니다.
그 결과 일부 후보 변이는 BDA-Sanger 분석으로 확인됐지만, 다른 후보 변이는 검출되지 않거나 최초 WES 결과와 다른 변이 형태로 확인됐습니다.
이러한 사례는 BDA가 단순히 변이를 많이 검출하는 기술이 아니라, 기존 sequencing에서 발견한 후보 변이를 추가로 검토하는 데 활용될 수 있음을 보여줍니다.
하지만 BDA-Sanger 결과도 독립적인 절대적 정답은 아닙니다.
BDA의 농축 편향과 PCR 오류 가능성을 고려해야 하며, 임상적으로 중요한 변이는 적절하게 검증된 분석법으로 확인할 필요가 있습니다.
참고 연구: Confirming putative variants at ≤5% allele frequency using allele enrichment and Sanger sequencing. Scientific Reports, 2021.
9. BDA를 이용해 원래 검체의 변이 비율을 계산할 수 있을까?
BDA는 변이 DNA를 선택적으로 농축하므로 PCR 이후의 변이 비율이 원래 검체의 VAF와 달라질 수 있습니다.
따라서 BDA 산물에서 변이 read가 50%를 차지한다고 해서 원래 검체의 변이 비율이 50%였다고 해석해서는 안 됩니다.
이 문제는 BDA를 정량 분석에 적용할 때 특히 중요합니다.
2021년 Nature Communications에 발표된 연구에서는 이러한 한계를 해결하기 위해 Quantitative Blocker Displacement Amplification(QBDA)을 제안했습니다.
QBDA는 원본 DNA 분자에 Unique Molecular Identifier(UMI)를 부착한 뒤 BDA를 수행하는 전략입니다.
이때 UMI는 서로 다른 원본 DNA 분자를 구별하는 데 사용됩니다.
따라서 BDA로 변이 서열을 농축하더라도 원본 DNA 분자의 정보를 추적해 정량 분석을 수행하도록 설계할 수 있습니다.
QBDA에서 UMI를 사용하는 이유
일반 BDA에서는 변이 DNA와 정상 DNA의 증폭 효율이 다릅니다.
따라서 최종 read 수만으로 원래 검체의 VAF를 계산하기 어렵습니다.
반면 UMI를 이용하면 동일한 원본 DNA에서 유래한 여러 PCR read를 구별할 수 있습니다.
이러한 정보를 활용하면 PCR amplification bias의 영향을 줄이면서 원본 DNA의 변이 비율을 추정할 수 있습니다.
다만 UMI가 모든 오류를 자동으로 제거하는 것은 아닙니다.
UMI 부착 과정에서 발생하는 오류와 barcode collision, 원본 DNA 손실 등의 문제도 고려해야 합니다.
참고 연구: Calibration-free NGS quantitation of mutations below 0.01% VAF. Nature Communications, 2021.
10. 실제 검사에서 BDA를 선택할 때 확인할 조건
BDA를 활용할지 판단하려면 단순히 검출한계가 낮다는 설명보다 분석 목적을 먼저 확인해야 합니다.
예를 들어 알려진 유전자 변이 하나를 정량적으로 측정하려는 경우에는 적절하게 검증된 digital PCR이 더 단순한 선택일 수 있습니다.
반면 특정 짧은 유전자 영역에 존재하는 여러 종류의 변이를 농축해 sequencing으로 확인하려는 경우에는 BDA가 유용할 수 있습니다.
다수의 유전자 영역을 동시에 분석해야 한다면 multiplex BDA 설계를 고려할 수 있습니다.
그러나 multiplex 반응에서는 primer와 blocker 사이의 상호작용이 증가할 수 있습니다.
따라서 각 표적에서 충분한 농축 효율과 균일한 반응 성능이 확보되는지 확인해야 합니다.
실험 설계 시 확인할 핵심 변수
| 확인 항목 | 중요한 이유 |
|---|---|
| Blocker 결합 영역 | 분석하려는 변이가 해당 영역에 포함되어야 함 |
| Primer-Blocker Overlap | 두 oligonucleotide 사이의 경쟁적 결합 형성 |
| Blocker의 3′ 말단 | 의도하지 않은 polymerase extension 방지 |
| Blocker와 Primer 농도 | 정상 DNA 억제와 변이 DNA 증폭의 균형 |
| DNA Input | 실제 변이 분자가 검체에 포함될 확률 |
| 후속 분석법 | 변이 존재 확인과 정량 분석의 목적 구분 |
이 가운데 blocker의 3′ 말단은 특히 중요합니다.
Blocker가 일반 PCR primer처럼 연장되면 의도하지 않은 증폭산물이 생성될 수 있기 때문입니다.
원천 연구에서는 blocker의 3′ 말단에 표적과 결합하지 않는 염기를 추가해 연장을 억제하는 방법을 사용했습니다.
다만 이러한 방식의 적합성은 사용하는 DNA polymerase와 반응 조건에 따라 달라질 수 있습니다.
따라서 다른 효소나 실험 조건에 그대로 적용하기보다는 별도의 검증이 필요합니다.
11. BDA는 액체생검에서 어떤 의미가 있을까?
액체생검에서는 혈액 속 cell-free DNA(cfDNA) 가운데 종양 유래 DNA(ctDNA)를 분석할 수 있습니다.
하지만 ctDNA의 양이 적으면 정상 cfDNA에 비해 변이 DNA의 비율이 매우 낮을 수 있습니다.
BDA는 정상 서열의 증폭을 억제해 저빈도 변이를 상대적으로 농축할 수 있으므로 이러한 분석에서 활용 가능성이 있습니다.
실제로 BDA 관련 연구에서는 암 관련 변이와 혈액 검체를 대상으로 분석 성능을 평가했습니다.
하지만 BDA가 낮은 VAF의 변이를 농축할 수 있다는 사실만으로 해당 변이가 반드시 종양에서 유래했다고 판단할 수는 없습니다.
혈액세포에서 발생한 clonal hematopoiesis 관련 변이도 혈액 cfDNA에서 검출될 수 있기 때문입니다.
또한 DNA 손상이나 PCR 오류에서 유래한 변이 신호가 농축될 가능성도 고려해야 합니다.
따라서 액체생검에서 BDA를 사용할 때는 분석적 정확도와 임상적 해석을 구분해야 합니다.
BDA는 변이 DNA를 상대적으로 더 쉽게 검출하도록 돕는 기술이지, 검출된 변이의 생물학적 기원까지 자동으로 판별하는 기술은 아닙니다.
12. BDA가 제공하는 고유한 분석적 가치
BDA는 정상 DNA와 변이 DNA의 상대적인 증폭 효율을 다르게 만드는 기술입니다.
기존의 allele-specific PCR은 특정 변이를 인식하도록 primer를 설계하는 경우가 많습니다.
반면 BDA에서는 정상 서열에 결합하는 blocker를 사용해 해당 영역의 다양한 변이를 상대적으로 농축할 수 있습니다.
또한 COLD-PCR처럼 DNA의 변성 온도 차이만을 이용하는 것이 아니라, primer와 blocker의 경쟁적 결합을 이용합니다.
이러한 특성은 특정 짧은 유전자 영역에서 여러 종류의 저빈도 변이를 분석하려는 연구에 활용될 수 있습니다.
다만 실제 검출 성능은 blocker design과 PCR 조건, 원본 DNA 분자 수, 후속 분석법에 따라 달라집니다.
특히 PCR 과정에서 새롭게 발생한 오류도 농축될 수 있으므로 낮은 VAF를 분석할 때는 적절한 대조군과 독립적인 확인 방법이 중요합니다.
BDA의 가장 중요한 특징은 변이 DNA를 직접 선택하는 대신 정상 DNA의 증폭을 억제함으로써, 상대적으로 적은 수의 변이 DNA가 후속 분석에서 더 쉽게 검출되도록 한다는 점입니다.
따라서 BDA를 평가할 때는 단순한 농축 배수보다 어떤 변이를 대상으로 하는지, 원래 검체의 VAF를 정량해야 하는지, 후속 분석에서 오류를 어떻게 확인할 것인지를 함께 고려해야 합니다.
참고문헌
1. Wu LR, Chen SX, Wu Y, Patel AA, Zhang DY. (2017).
Multiplexed enrichment of rare DNA variants via sequence-selective and temperature-robust amplification.
Nature Biomedical Engineering, 1, 714–723.
DOI: https://doi.org/10.1038/s41551-017-0126-5
BDA의 기본 원리와 primer-blocker overlap, 선택적 변이 농축, 온도 안정성을 제시한 원천 연구입니다.
2. Confirming putative variants at ≤5% allele frequency using allele enrichment and Sanger sequencing. (2021).
Scientific Reports.
DOI: https://doi.org/10.1038/s41598-021-91142-1
BDA를 이용해 저빈도 후보 변이를 농축하고 Sanger sequencing으로 확인하는 접근을 평가한 연구입니다.
3. Calibration-free NGS quantitation of mutations below 0.01% VAF. (2021).
Nature Communications.
DOI: https://doi.org/10.1038/s41467-021-26308-6
UMI와 BDA를 결합한 QBDA를 제시하고, 저빈도 변이의 정량 분석 방법을 연구한 논문입니다.
4. Recent Developments in Mutation Enrichment and Detection Technologies. (2022).
Clinical Chemistry, 68(10), 1250–1262.
BDA를 포함한 다양한 저빈도 유전자 변이 농축 기술의 원리와 제한 요소를 비교한 검토 문헌입니다.
※ 본 글은 공개된 학술논문에 근거해 BDA의 작동 원리와 연구 결과를 설명한 교육용 콘텐츠입니다. 특정 연구에서 보고된 변이 농축 효율과 검출한계가 모든 검체 또는 임상 검사에서 동일하게 재현되는 것은 아닙니다.


댓글 0
첫 댓글을 남겨보세요.