Proximity Extension Assay를 활용한 다중 단백질 바이오마커 검출 원리
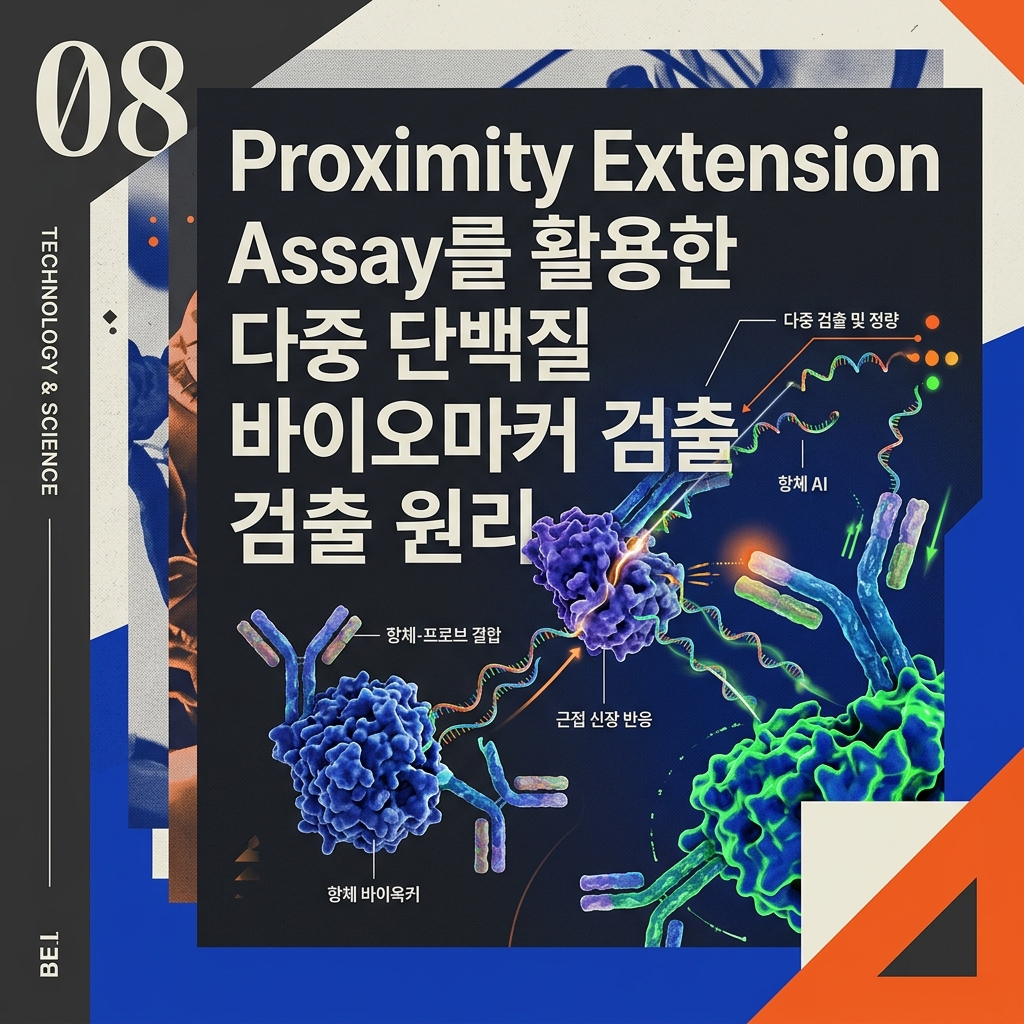
Proximity Extension Assay(PEA)는 두 항체가 같은 표적 단백질에 결합했을 때 가까워진 DNA oligonucleotide를 polymerase가 연장하도록 설계한 분석법입니다. 단백질 인식을 DNA 정보로 바꾸기 때문에 PCR이나 sequencing을 이용한 다중 단백질 분석으로 확장할 수 있습니다.
단백질 검출에 왜 DNA를 사용할까?
Protein biomarker를 측정하는 대표적인 방법에는 immunoassay가 있습니다.
Antibody가 target protein을 인식하고 enzyme, fluorescence 또는 chemiluminescence를 이용해 signal을 만듭니다.
하지만 많은 protein을 동시에 측정하려면 각각의 signal을 서로 구별해야 합니다.
DNA는 이 문제를 해결하는 데 유용한 molecular information carrier가 될 수 있습니다.
DNA에는 서로 다른 sequence를 설계할 수 있기 때문입니다.
각 protein에 대응하는 antibody에 고유한 DNA sequence를 연결하면 protein identity를 DNA identity로 변환할 수 있습니다.
PEA는 이러한 원리를 proximity-dependent polymerase extension과 결합합니다.
PEA의 기본 구성
가장 기본적인 PEA에서는 동일한 target protein의 서로 다른 epitope를 인식하는 두 affinity probe를 사용합니다.
각 probe는
Antibody
DNA Oligonucleotide
로 구성됩니다.
이를 antibody-oligonucleotide conjugate라고 생각할 수 있습니다.
두 antibody가 같은 target protein에 결합하면 각각에 연결된 DNA strand도 공간적으로 가까워집니다.
이 proximity가 다음 DNA reaction을 시작할 수 있는 조건이 됩니다.
Target이 없을 때는 어떻게 될까?
Target protein이 없다면 두 antibody-DNA conjugate는 solution에서 독립적으로 이동합니다.
DNA strand가 일시적으로 충돌할 수는 있지만 서로 안정적인 extension complex를 만들 확률은 낮도록 설계합니다.
따라서 target이 없는 상태에서는 polymerase가 증폭 가능한 DNA product를 만드는 반응을 최소화하는 것이 중요합니다.
반대로 target이 존재하면 두 antibody가 같은 molecule에 결합합니다.
그 결과 DNA strand의 effective local concentration이 증가합니다.
이제 두 oligonucleotide가 서로 hybridization할 가능성이 높아집니다.
Proximity가 Local Concentration을 바꾼다
PEA에서 중요한 것은 target이 DNA를 직접 합성한다는 것이 아닙니다.
Target protein은 두 DNA probe를 가까이 모아주는 molecular scaffold 역할을 합니다.
Solution 전체에서 DNA 농도가 낮더라도 target 표면의 좁은 공간에서는 두 DNA strand가 매우 가까워질 수 있습니다.
즉,
Target Binding
→ Probe Proximity
→ Local DNA Concentration 증가
→ DNA Hybridization
으로 연결됩니다.
이러한 proximity dependence가 protein recognition event와 DNA reaction을 연결합니다.
DNA Extension은 어떻게 시작될까?
두 proximity probe의 DNA에는 서로 상보적으로 결합할 수 있는 영역을 설계할 수 있습니다.
Target에 의해 두 strand가 가까워지면 이 영역이 hybridization합니다.
한쪽 DNA의 3′ end가 다른 DNA를 template로 사용할 수 있는 구조가 형성될 수 있습니다.
DNA polymerase가 nucleotide를 추가하면서 strand를 연장합니다.
그 결과 두 proximity probe의 정보를 포함하는 새로운 DNA product가 만들어집니다.
즉,
Protein Recognition
→ DNA Proximity
→ Hybridization
→ Polymerase Extension
→ Amplifiable DNA Template
가 PEA의 핵심 구조입니다.
PLA와 가장 큰 차이는 무엇일까?
직전 글에서 살펴본 Proximity Ligation Assay(PLA)와 기본 아이디어는 비슷합니다.
두 기술 모두 affinity probe에 DNA를 연결합니다.
두 probe가 target 때문에 가까워졌을 때 DNA signal을 생성합니다.
차이는 DNA product를 만드는 reaction입니다.
PLA
Proximity
→ DNA End 정렬
→ Ligase가 DNA 연결
PEA
Proximity
→ DNA Hybridization
→ Polymerase가 DNA 연장
따라서 PLA에서는 ligation이 핵심이고 PEA에서는 extension이 핵심입니다.
PEA에서 Polymerase는 Target을 증폭하는 것이 아니다
PEA를 nucleic acid amplification과 혼동하기 쉽습니다.
첫 번째 polymerase extension 단계에서 protein 자체가 복제되는 것은 아닙니다.
Target protein이 만들어낸 proximity information이 DNA product로 변환됩니다.
이후 PCR을 사용한다면 새롭게 생성된 DNA template가 증폭됩니다.
따라서
Protein → Recognition Target
Proximity Extension → Protein 정보를 DNA로 변환
PCR → DNA Product 증폭
으로 역할을 나눠야 합니다.
Extension Product에 Protein의 Identity를 기록할 수 있다
PEA의 강력한 특징은 DNA sequence를 barcode로 사용할 수 있다는 점입니다.
Protein A를 인식하는 antibody pair에는 A를 나타내는 DNA sequence를 넣을 수 있습니다.
Protein B에는 B를 나타내는 다른 sequence를 연결합니다.
Protein C에도 별도의 sequence를 사용할 수 있습니다.
Target-dependent extension이 성공하면 생성된 DNA product 안에 어떤 protein에서 유래한 signal인지 구분할 수 있는 sequence information이 남습니다.
즉,
Protein Identity
→ DNA Sequence Identity
로 변환됩니다.
DNA Barcode가 Multiplexing을 가능하게 한다
Fluorescence 기반 multiplex assay에서는 fluorophore spectrum의 overlap이 문제가 될 수 있습니다.
DNA barcode는 매우 많은 sequence combination을 설계할 수 있습니다.
따라서 서로 다른 protein assay를 sequence level에서 구분하는 전략을 사용할 수 있습니다.
예를 들어 하나의 sample에 여러 antibody pair를 넣은 뒤 target-dependent DNA product를 생성합니다.
이후 각각의 barcode를 qPCR 또는 sequencing으로 판별할 수 있습니다.
이러한 구조가 PEA가 multiplex protein profiling에 활용될 수 있는 중요한 이유입니다.
Multiplexing이 많아지면 새로운 문제가 생긴다
Protein target을 많이 추가한다고 assay가 자동으로 좋아지는 것은 아닙니다.
수많은 antibody가 같은 reaction mixture에 존재하면 서로 비특이적으로 상호작용할 가능성이 증가합니다.
DNA oligonucleotide끼리 unintended hybridization이 발생할 수도 있습니다.
서로 다른 probe pair 사이에서 잘못된 extension product가 만들어지는 cross-reactivity도 관리해야 합니다.
따라서 multiplex PEA에서는 antibody specificity뿐 아니라 DNA sequence orthogonality가 중요합니다.
DNA Sequence Orthogonality란 무엇일까?
서로 다른 assay에 사용하는 oligonucleotide가 원하지 않는 상대와 hybridization하지 않도록 설계하는 것을 생각할 수 있습니다.
Protein A용 DNA가 Protein B나 C용 DNA와 강하게 결합하면 target과 무관한 extension이 발생할 수 있습니다.
따라서 barcode와 hybridization 영역을 설계할 때 sequence similarity와 secondary structure를 확인해야 합니다.
Multiplex 수가 증가할수록 이러한 design problem도 복잡해집니다.
PEA는 protein assay인 동시에 정교한 DNA sequence engineering 기술인 셈입니다.
qPCR로 PEA Product를 읽는 방법
Extension product에 특정 primer-binding region을 포함시키면 PCR amplification이 가능합니다.
qPCR을 사용하면 amplification과 함께 fluorescence를 측정할 수 있습니다.
Target protein이 많을수록 더 많은 proximity extension product가 만들어질 가능성이 있고 최종 qPCR signal도 달라질 수 있습니다.
하지만 측정된 Cq 값은 여러 단계를 거친 결과입니다.
Antibody Binding
Proximity Formation
DNA Hybridization
Polymerase Extension
PCR Amplification
모두 최종 signal에 영향을 줍니다.
따라서 qPCR 결과를 protein concentration으로 변환하려면 적절한 calibration이 필요합니다.
Sequencing으로 읽으면 무엇이 달라질까?
Target protein마다 고유한 DNA barcode가 존재한다면 sequencing을 이용해 여러 barcode를 동시에 읽을 수 있습니다.
Sequencing read에서 barcode identity를 확인하고 각 barcode가 얼마나 관찰됐는지 계산합니다.
개념적으로
Protein A → Barcode A
Protein B → Barcode B
Protein C → Barcode C
로 변환됩니다.
따라서 optical channel을 하나씩 추가하지 않고 DNA sequence 자체를 multiplex label로 사용할 수 있습니다.
이것은 protein measurement를 nucleic acid counting problem으로 바꾸는 접근입니다.
NGS를 사용한다고 Protein Sequence를 읽는 것은 아니다
이 부분은 구분할 필요가 있습니다.
PEA product를 sequencing한다고 해서 원래 protein의 amino-acid sequence를 읽는 것은 아닙니다.
Sequencer가 읽는 것은 antibody에 미리 연결해 둔 DNA barcode와 extension product입니다.
따라서
DNA Sequence → 어떤 Antibody Pair가 반응했는지 식별
하는 역할을 합니다.
Protein identification은 antibody specificity에 의존합니다.
Sequencing은 그 recognition event를 기록한 DNA를 판독합니다.
낮은 농도의 Protein을 측정하는 원리
PEA에서는 target protein이 두 antibody를 가까이 모은 뒤 DNA product가 생성됩니다.
그 product를 PCR로 증폭할 수 있습니다.
따라서 매우 적은 protein recognition event를 많은 DNA amplicon으로 변환할 가능성이 있습니다.
하지만 낮은 detection limit을 얻으려면 background extension이 충분히 낮아야 합니다.
Target이 없는 상태에서 DNA product가 계속 생성된다면 PCR이 그 background까지 증폭하기 때문입니다.
따라서 높은 analytical sensitivity에는
강한 Target-Dependent Signal
뿐 아니라
낮은 Target-Independent Background
가 동시에 필요합니다.
Background Extension은 어떻게 생길까?
Target이 없어도 proximity probe가 solution에서 우연히 가까워질 수 있습니다.
Probe concentration이 높아지면 collision frequency도 증가합니다.
DNA의 complementary region이 지나치게 안정하면 target이 없어도 hybridization할 수 있습니다.
Polymerase가 이러한 구조를 연장하면 false product가 만들어집니다.
따라서 PEA에서는 DNA hybridization strength를 매우 세밀하게 조절해야 합니다.
Target이 있을 때는 extension이 가능하지만 target이 없을 때는 안정적인 complex가 잘 만들어지지 않는 조건이 필요합니다.
Antibody Pair가 중요한 이유
두 antibody는 같은 target protein의 서로 다른 epitope에 동시에 결합할 수 있어야 합니다.
두 epitope가 너무 가까우면 steric hindrance가 발생할 수 있습니다.
한 antibody가 결합하면서 다른 antibody의 binding site를 가릴 수도 있습니다.
반대로 두 epitope가 너무 멀리 떨어져 있으면 연결된 DNA oligonucleotide가 효율적으로 interaction하지 못할 수 있습니다.
따라서 affinity만 높은 antibody 두 개를 임의로 선택한다고 좋은 PEA pair가 되는 것은 아닙니다.
Epitope Geometry와 Probe Architecture를 함께 고려해야 합니다.
Protein Complex가 결과에 영향을 줄 수도 있다
혈액 속 protein은 항상 독립적인 monomer 상태로 존재하지 않습니다.
다른 protein과 complex를 형성할 수 있습니다.
Ligand나 autoantibody와 결합할 수도 있습니다.
이러한 interaction이 antibody epitope를 가리면 target protein이 존재해도 proximity probe가 제대로 결합하지 못할 수 있습니다.
반대로 서로 다른 protein이 자연적으로 가까이 존재하는 complex를 형성하면 assay architecture에 따라 proximity signal에 영향을 줄 수도 있습니다.
따라서 PEA 결과는 단순한 total protein amount 외에 molecular accessibility의 영향을 받을 수 있습니다.
혈액 속 Abundant Protein은 왜 문제가 될까?
Plasma에는 albumin과 immunoglobulin을 비롯해 매우 높은 농도의 protein이 존재합니다.
반면 일부 disease biomarker는 극히 낮은 농도로 존재할 수 있습니다.
Abundant protein이 probe surface와 비특이적으로 상호작용하거나 target binding을 방해하면 background와 matrix effect가 발생할 수 있습니다.
PEA가 PCR amplification을 사용한다고 해서 plasma matrix 문제가 자동으로 해결되는 것은 아닙니다.
Upstream protein recognition 단계는 여전히 immunoassay chemistry의 영향을 받습니다.
Dynamic Range가 중요한 이유
혈액 속 protein concentration은 target에 따라 매우 큰 차이가 있습니다.
어떤 protein은 높은 농도로 존재하고 다른 cytokine이나 signaling protein은 매우 낮은 농도로 존재할 수 있습니다.
여러 protein을 한 reaction에서 측정하려면 이러한 concentration 차이를 처리할 수 있어야 합니다.
Probe affinity와 concentration, amplification condition 등을 조절해야 할 수 있습니다.
특정 target의 signal이 지나치게 강해 다른 target 분석에 영향을 주지 않는지도 확인해야 합니다.
Protein을 많이 넣으면 Signal이 항상 증가할까?
일반적으로 target concentration이 증가하면 proximity complex도 증가할 수 있습니다.
하지만 매우 높은 target concentration에서는 두 antibody가 서로 다른 target molecule에 각각 결합하는 상황이 발생할 수 있습니다.
그 결과 동일한 target에 두 probe가 동시에 모이는 비율이 감소할 가능성이 있습니다.
이러한 현상은 sandwich immunoassay에서 알려진 hook effect와 유사한 문제로 고려할 수 있습니다.
따라서 assay의 전체 dynamic range를 실험적으로 확인해야 합니다.
PEA는 Absolute Quantification 기술일까?
PEA signal은 target protein 양과 연관될 수 있지만 모든 PEA 결과가 자동으로 absolute concentration을 의미하는 것은 아닙니다.
특히 대규모 protein profiling에서는 normalized relative signal 형태로 결과를 표현하는 assay도 있습니다.
Absolute concentration을 얻으려면 적절한 standard와 calibration curve가 필요합니다.
따라서 PEA 데이터를 볼 때는 결과 단위가
Absolute Concentration인지
또는
Normalized Relative Abundance인지
확인해야 합니다.
PEA와 ELISA를 비교하면
| 구분 | ELISA | PEA |
|---|---|---|
| 표적 | Protein | Protein |
| 주요 인식 | Antibody | Antibody Pair |
| Signal 변환 | Enzyme reporter 등 | DNA Extension Product |
| 후속 검출 | Colorimetric·Luminescence 등 | qPCR·Sequencing 등 |
| DNA Barcode | 일반적으로 사용하지 않음 | 활용 가능 |
| Multiplex 확장 | Platform에 따라 제한 | DNA sequence 기반 확장 가능 |
| Protein 자체 증폭 | 없음 | 없음 |
PEA에서도 protein 자체가 증폭되는 것은 아닙니다.
증폭되는 것은 protein recognition을 기록한 DNA product입니다.
PLA와 PEA를 다시 비교하면
| 구분 | PLA | PEA |
|---|---|---|
| 공통 원리 | Target-dependent probe proximity | Target-dependent probe proximity |
| DNA 생성 핵심 | Ligation | Polymerase extension |
| 핵심 효소 | Ligase | DNA polymerase |
| 후속 증폭 | PCR·RCA 등 | PCR 등 |
| Multiplexing | DNA barcode 활용 가능 | DNA barcode 활용 가능 |
| 주요 분석 대상 | Protein·molecular proximity | Protein profiling |
두 기술은 서로 매우 가까운 개념이지만 DNA information을 만드는 chemistry가 다릅니다.
Cytokine Panel 분석에는 왜 유용할까?
Cytokine은 immune response와 inflammation에 관여하는 protein입니다.
하나의 cytokine만 측정하는 것보다 여러 cytokine의 조합을 분석해야 하는 연구가 많습니다.
PEA에서는 각 cytokine에 다른 antibody pair와 DNA barcode를 사용할 수 있습니다.
그 결과 작은 sample volume에서 여러 protein을 동시에 분석하는 high-multiplex assay로 발전시킬 수 있습니다.
다만 cytokine 변화가 특정 질환에만 특이적이지 않을 수 있으므로 biomarker interpretation에는 임상적 맥락이 필요합니다.
암 연구에서는 어떻게 사용할까?
Cancer cell과 tumor microenvironment에서는 다양한 signaling protein과 inflammatory mediator가 변할 수 있습니다.
혈장에서 이러한 protein panel을 측정하면 disease-associated protein signature를 탐색할 수 있습니다.
예를 들어 하나의 marker가 아니라 여러 protein의 relative abundance pattern을 분석할 수 있습니다.
이후 statistical model이나 machine learning을 이용해 환자군과 대조군을 비교할 수 있습니다.
하지만 특정 cohort에서 발견된 protein signature가 바로 임상 암 진단법이 되는 것은 아닙니다.
Independent validation이 필요합니다.
단백질 Panel이 단일 Biomarker보다 유리할 수 있는 이유
한 가지 protein은 여러 질환이나 physiological condition에서 변할 수 있습니다.
따라서 하나의 biomarker만으로 높은 disease specificity를 얻기 어려운 경우가 있습니다.
여러 protein을 함께 분석하면 더 복잡한 biological state를 표현할 수 있습니다.
예를 들어
Protein A 증가
Protein B 감소
Protein C 변화 없음
Protein D 증가
같은 multidimensional signature를 만들 수 있습니다.
PEA의 multiplex capability는 이러한 protein panel 연구에 적합합니다.
Machine Learning을 결합할 때 주의할 점
수백 개의 protein을 측정하면 sample 하나에서도 많은 feature가 생성됩니다.
Machine-learning model을 사용하면 이러한 feature를 조합해 disease classification을 시도할 수 있습니다.
하지만 환자 수보다 protein feature 수가 지나치게 많으면 overfitting이 발생하기 쉽습니다.
Training cohort에서는 높은 accuracy를 보이지만 새로운 population에서는 성능이 떨어질 수 있습니다.
따라서 discovery와 validation cohort를 분리해야 합니다.
Age, sex, medication과 inflammatory condition 같은 confounding factor도 고려해야 합니다.
PEA와 Liquid Biopsy의 관계
Liquid biopsy에서는 혈액 속 다양한 biomarker를 분석합니다.
cfDNA mutation과 methylation,
cfDNA fragmentomics,
EV-associated miRNA,
circulating protein
등이 서로 다른 biological information을 제공합니다.
PEA는 이 가운데 circulating protein layer를 고다중으로 분석할 수 있는 기술적 접근입니다.
따라서 cfDNA와 PEA protein panel을 결합하면 genome-derived signal과 proteome-derived signal을 동시에 사용하는 multi-analyte strategy를 연구할 수 있습니다.
cfDNA와 Protein은 어떤 차이가 있을까?
cfDNA mutation은 tumor genome의 sequence alteration에 관한 정보를 줄 수 있습니다.
Protein concentration은 gene expression과 translation, secretion, degradation 등 여러 biological process의 결과입니다.
따라서 DNA와 protein은 같은 질환에서도 서로 다른 정보를 제공합니다.
예를 들어 tumor DNA signal이 매우 낮더라도 host immune response와 관련된 protein이 변할 수 있습니다.
반대로 protein biomarker는 inflammation 같은 비암성 상태에서도 변할 수 있습니다.
두 biomarker를 결합할 때는 이러한 장단점을 함께 고려해야 합니다.
Sample Volume이 적다는 것은 왜 중요할까?
다중 protein 분석에서 각각의 target마다 별도의 sample을 사용한다면 많은 혈액이 필요할 수 있습니다.
Multiplex PEA에서는 하나의 작은 sample aliquot에서 많은 protein을 동시에 분석하는 방향으로 설계할 수 있습니다.
특히 longitudinal monitoring처럼 같은 환자에게서 반복적으로 sample을 얻어야 하는 연구에서는 sample requirement가 중요합니다.
하지만 필요한 실제 sample volume은 assay platform과 protocol에 따라 다르므로 하나의 값으로 일반화할 수 없습니다.
PEA 결과를 해석할 때 가장 중요한 부분
PEA에서 강한 DNA signal이 검출됐다는 것은 해당 antibody pair가 target-dependent proximity event를 만들었다는 의미입니다.
하지만 그 결과를 질환과 연결하려면 별도의 biological validation이 필요합니다.
즉,
Analytical Detection
과
Clinical Interpretation
을 구분해야 합니다.
낮은 농도의 protein을 정확하게 측정할 수 있다는 사실과 그 protein이 특정 암을 정확하게 진단한다는 사실은 서로 다른 문제입니다.
Pre-Analytical Variable도 무시할 수 없다
혈액 채취 후 처리 시간이 달라지면 일부 protein 농도가 변할 수 있습니다.
Serum과 plasma에서도 결과가 다를 수 있습니다.
사용한 anticoagulant가 assay에 영향을 줄 가능성도 고려해야 합니다.
Freeze-thaw가 반복되면 일부 protein stability가 달라질 수 있습니다.
Hemolysis가 발생하면 blood cell 내부 protein이 sample에 방출될 수 있습니다.
따라서 PEA처럼 정밀한 multiplex assay에서도 sample collection과 storage standardization이 필요합니다.
PEA 분석의 기본 구조를 정리하면
가장 단순한 형태는 다음과 같습니다.
Target이 없는 경우
Probe A + Probe B
→ DNA가 충분히 가까워지지 않음
→ 낮은 Hybridization Probability
→ 적은 Extension Product
→ Low PCR Signal
Target이 존재하는 경우
Probe A + Target Protein + Probe B
→ Dual Recognition
→ DNA Proximity
→ Complementary Region Hybridization
→ Polymerase Extension
→ Protein-Specific DNA Product
→ PCR 또는 Sequencing
→ Protein Signal Quantification
이 과정에서 target protein의 존재가 DNA product 생성 조건으로 변환됩니다.
PEA의 주요 기술적 한계
PEA의 높은 multiplexing capability만 강조하면 실제 assay의 어려움을 놓칠 수 있습니다.
주요 과제에는
Antibody Cross-Reactivity
Epitope Accessibility
Antibody-DNA Conjugation Variation
Background Hybridization
Nonspecific Extension
Barcode Cross-Talk
PCR Bias
Sample Matrix Effect
등이 있습니다.
Multiplex 수가 증가할수록 이러한 변수를 동시에 관리해야 합니다.
임상 활용으로 이어지려면
PEA를 이용해 disease-associated protein panel을 발견한 뒤에는 별도의 validation 과정이 필요합니다.
독립적인 환자군에서 같은 signature가 재현되는지 확인해야 합니다.
Disease stage에 따라 성능이 달라지는지도 평가해야 합니다.
Benign disease와 inflammatory condition에서도 false-positive signal이 발생하지 않는지 확인해야 합니다.
다른 검사실과 reagent lot에서도 결과가 재현되어야 합니다.
따라서 기술적으로 많은 protein을 측정할 수 있다는 것과 임상적으로 유용한 diagnostic panel이 확립됐다는 것은 구분해야 합니다.
PEA가 분자진단에서 갖는 의미
PEA의 가장 흥미로운 부분은 protein detection 결과를 그대로 optical signal로 끝내지 않는다는 점입니다.
Protein recognition event를 DNA sequence information으로 바꿉니다.
그러면 분자진단 분야에서 이미 발전한
PCR,
qPCR,
digital counting,
sequencing,
DNA barcoding
기술을 protein analysis에 활용할 수 있습니다.
즉, 단백질을 핵산으로 변환하는 것이 아니라 단백질을 인식했다는 사건을 읽을 수 있는 DNA record로 변환하는 것입니다.
이 때문에 PEA는 proteomics와 nucleic acid molecular diagnostics 사이를 연결하는 기술로 볼 수 있습니다.
마치며
Proximity Extension Assay는 두 antibody-DNA probe가 같은 target protein을 인식했을 때 발생하는 molecular proximity를 polymerase extension으로 DNA signal에 기록하는 기술입니다.
기본 과정은
Protein Recognition
→ 두 Proximity Probe의 접근
→ DNA Hybridization
→ Polymerase Extension
→ Protein-Specific DNA Product
→ PCR 또는 Sequencing
→ Multiplex Protein Quantification
으로 정리할 수 있습니다.
PLA가 ligase를 이용해 proximity information을 DNA로 기록한다면 PEA는 polymerase extension을 사용한다는 점에서 차이가 있습니다.
또한 서로 다른 protein target에 고유한 DNA barcode를 부여하면 여러 protein recognition event를 sequence level에서 구별할 수 있습니다.
PEA의 핵심은 높은 PCR sensitivity 자체에만 있지 않습니다. 항체가 인식한 단백질의 종류를 DNA sequence로 부호화하고, 서로 가까워진 probe에서만 새로운 DNA product가 생성되도록 함으로써 복잡한 protein measurement를 정밀한 nucleic acid counting 문제로 변환한다는 것이 중요한 특징입니다.
※ 본 글은 Proximity Extension Assay와 multiplex protein biomarker 분석의 원리를 설명하기 위한 교육 목적의 콘텐츠입니다. 특정 연구에서 발견된 protein signature나 분석적 검출 성능을 특정 질환에 대해 확립된 임상 진단 성능으로 해석해서는 안 됩니다.


댓글 0
첫 댓글을 남겨보세요.